第 3 课
平均收益更高,为什么还不能说 8 赢了?
一起查看平均数、中位数、正收益比例与完整分布,避免让一个漂亮数字替整组证据说话。
蛙兄打开上一课的结果图,第一眼就盯住了平均收益。
带 8 组是 19.88%,不带 8 组是 14.90%。
“多了快 5 个百分点。”
他拿起笔,在带 8 组旁边画了一只小奖杯。
“我宣布,8 赢了。”
蛙博士没有抢走他的笔,只是指了指下一行。
“中位数呢?”
带 8 组是 -0.50%,不带 8 组是 -1.65%。两边都在零以下。
“那……还是带 8 组少跌一点。”
“正收益比例呢?”
49.45% 和 46.80%。两组都没有超过一半,相差也不算大。
蛙兄看了看刚画好的奖杯,又看了看整张表。
“怎么同一场比赛,几个数字说得不太一样?”
因为它们本来就在回答不同的问题。
平均数没有算错,中位数也没有故意唱反调。真正的问题是:我们不能只听见第一个数字,就让其他数字闭嘴。
研究结果通常不只有一个数字。不同数字在回答不同的问题。读结果时,我们要把它们放在一起,而不是只挑最支持原假设的那个。
先看看数字背后站着多少家公司
这次进入比较的虚构公司一共有 294 家。
其中,带 8 组有 91 家,不带 8 组有 203 家。
两组大小并不一样。
这不代表实验做错了。两组人数是按照代码里有没有字符 8 自然分出来的,我们没有为了让人数整齐,强行从某一组删掉公司。
但读结果时,样本数不能被藏起来。
“正收益比例 49.45%”听起来像一个抽象百分比。如果把它换回公司,大约就是 91 家公司里有 45 家取得正收益。
“正收益比例 46.80%”则是 203 家公司里有 95 家取得正收益。
百分比方便我们比较不同大小的组,人数则提醒我们:这些百分比背后究竟站着多少家公司。
平均收益,把全队装进一个数字
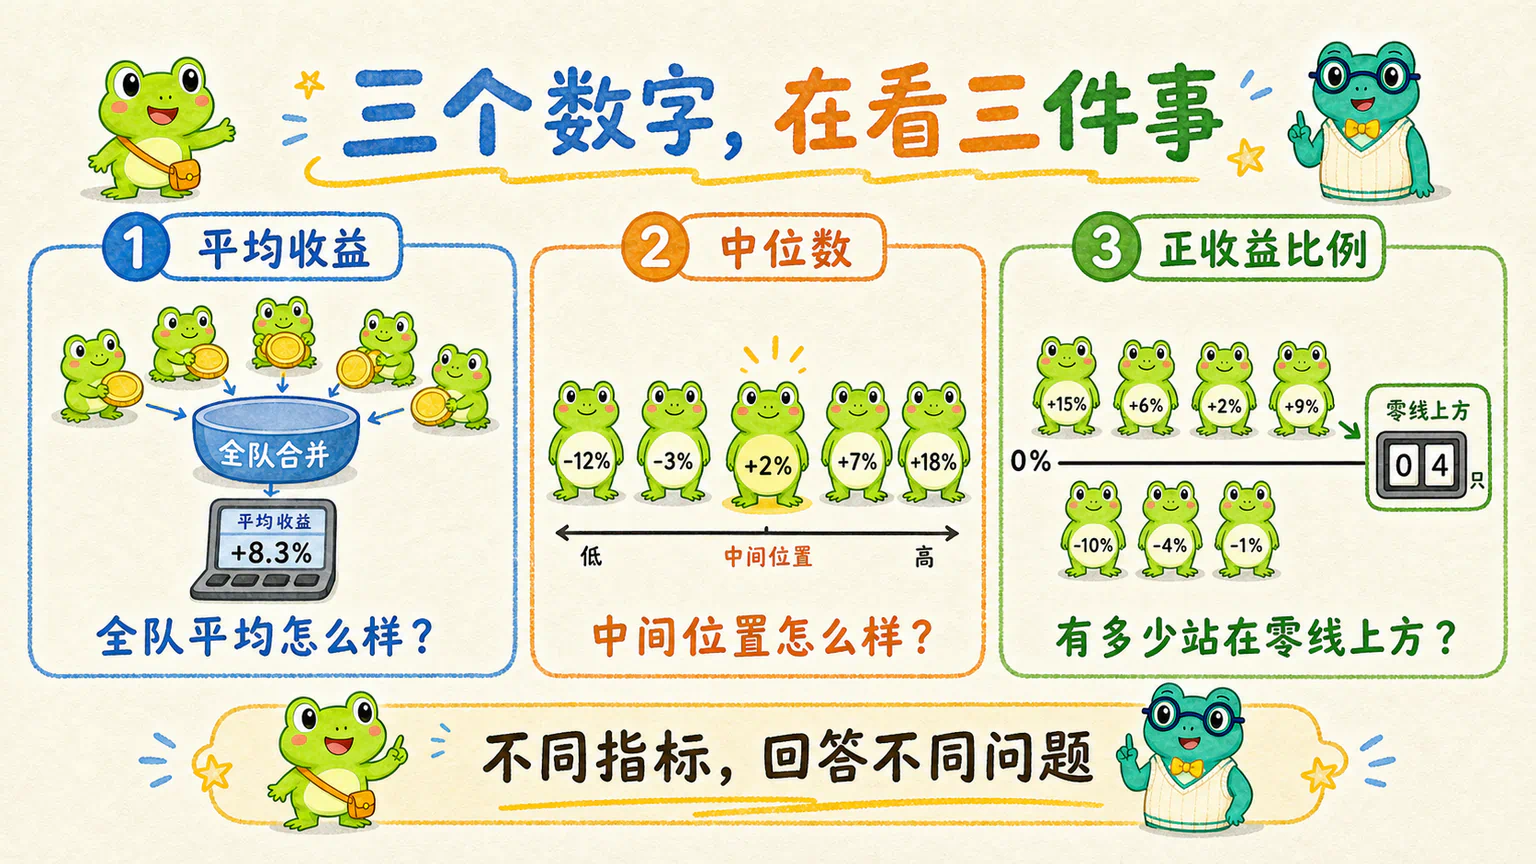
平均收益的算法很直白:把一组里每家公司的收益加在一起,再除以公司数量。
它回答的是:
如果每家公司在组内占同样的分量,这一组平均表现怎么样?
带 8 组的平均收益是 19.88%,不带 8 组是 14.90%。前者高出 4.98 个百分点。
这里说“百分点”,只是因为我们正在比较两个百分比之间的距离:
19.88% - 14.90% = 4.98 个百分点
到这里,蛙兄没有看错。带 8 组的平均收益确实更高。
但是,平均数有一个很明显的脾气:特别高或特别低的少数结果,会把它拉走。
假设五只青蛙今天一共捡到了 15 枚硬币,其中四只各捡到 1 枚,最后一只捡到 11 枚。
平均下来,每只青蛙捡到 3 枚。
这个平均数没有错。但如果你据此想象“每只青蛙大概都捡到了 3 枚”,就会和现场差得很远。
股票收益也是一样。少数涨得特别多的公司,可以把整组平均收益明显抬高。
中位数,看看排在中间的公司
中位数不把所有收益加起来。
它先让一组公司的收益从低到高排成一队,再找到站在正中间的位置。
所以,中位数更像在回答:
如果我们看看这支队伍中间的位置,那家公司表现怎么样?
带 8 组的中位数是 -0.50%,不带 8 组是 -1.65%。
带 8 组依然略高,但两边都小于零。
这意味着,在两支队伍中间位置附近的公司,研究期收益都是轻微负数。
它没有证明平均数是假的,也没有宣布不带 8 组获胜。它只是让“带 8 组整体大获全胜”这个故事听起来没那么痛快了。
正收益比例,只数有多少家公司站在零线上方
正收益比例做的事情更简单:看看一组里有多少家公司研究期收益严格大于零。
它不在乎某家公司上涨 1%,还是上涨 300%。只要高于零,就记作一家正收益公司。
因此,它回答的是:
这组公司里,有多大比例在这段时间上涨?
带 8 组的正收益比例是 49.45%,不带 8 组是 46.80%,相差 2.65 个百分点。
这两个数字都在一半附近。
它们告诉我们,带 8 组取得正收益的公司比例略高;它们没有告诉我们,带 8 组里的每家公司涨得更多。
最大值和最小值,是提醒,不是删除按钮
我们再看看两组最夸张的公司。
带 8 组的最大收益是 368.76%,最小收益是 -66.99%。
不带 8 组的最大收益是 625.12%,最小收益是 -63.98%。
这些最大值与两组中位数相距很远,也解释了为什么平均收益会比中位数高出那么多:少数特别高的收益正在把平均数往上拉。
看到极端值以后,我们可以继续追问它们来自哪里、数据是否正常,以及结果对它们有多敏感。
但不能因为它们让结果不好解释,就直接删掉。
如果一家公司确实符合我们事先固定的入选条件,它的收益再夸张,也仍然属于这次研究结果的一部分。删除数据需要事先说得通的规则,不能靠“这个点看着不顺眼”。
别只看三根柱子,让每家公司自己站出来
上一课的结果卡适合快速比较几个汇总数字,但它没有告诉我们 294 家公司分别落在什么位置。
现在可以让 AI 继续使用同一批研究期结果,再生成一张公司收益分布图。
这不是修改实验,也不是重新挑选指标。我们只是把已经计算过的每家公司收益画出来,让藏在平均数背后的分布变得可见。
交给 AI 研究助手|绘制公司收益分布
请继续使用刚才已经确认的同一批 294 家虚构公司、同一套分组规则,以及 2021-01-04 至 2022-12-30 的每家公司研究期收益。
不要修改入选条件,不要重新挑选公司,不要读取、计算或透露 2023 年收益,也不要加入行业、市值、PE、沪深300或其他数字。
请使用程序生成一张 PNG 收益分布图。每家公司用一个点表示,带 8 组和不带 8 组分开放置,并画出 0% 收益线。请同时标出两组的样本数、平均收益和中位数。
因为少数公司收益特别高,请在同一张图片中提供两个视角:一个展示全部收益范围,用来保留极端值;另一个放大 -100% 至 100% 的主要区域,用来看清大多数公司。两个视角必须使用同一批数据,并明确说明放大视角没有删除范围外的公司。
图中不要添加“8 有效”“谁是赢家”或任何买卖结论。完成后请实际运行程序,确认图中点数、样本数、平均收益和中位数与现有研究摘要一致,再告诉我图片保存在哪里。
这张图不是让 AI 凭感觉画一团差不多的点。每个点都必须来自一家公司实际算出的研究期收益。
所以,这是一张数据图,不是 AI 插画。
点都站出来以后,我们看见了什么
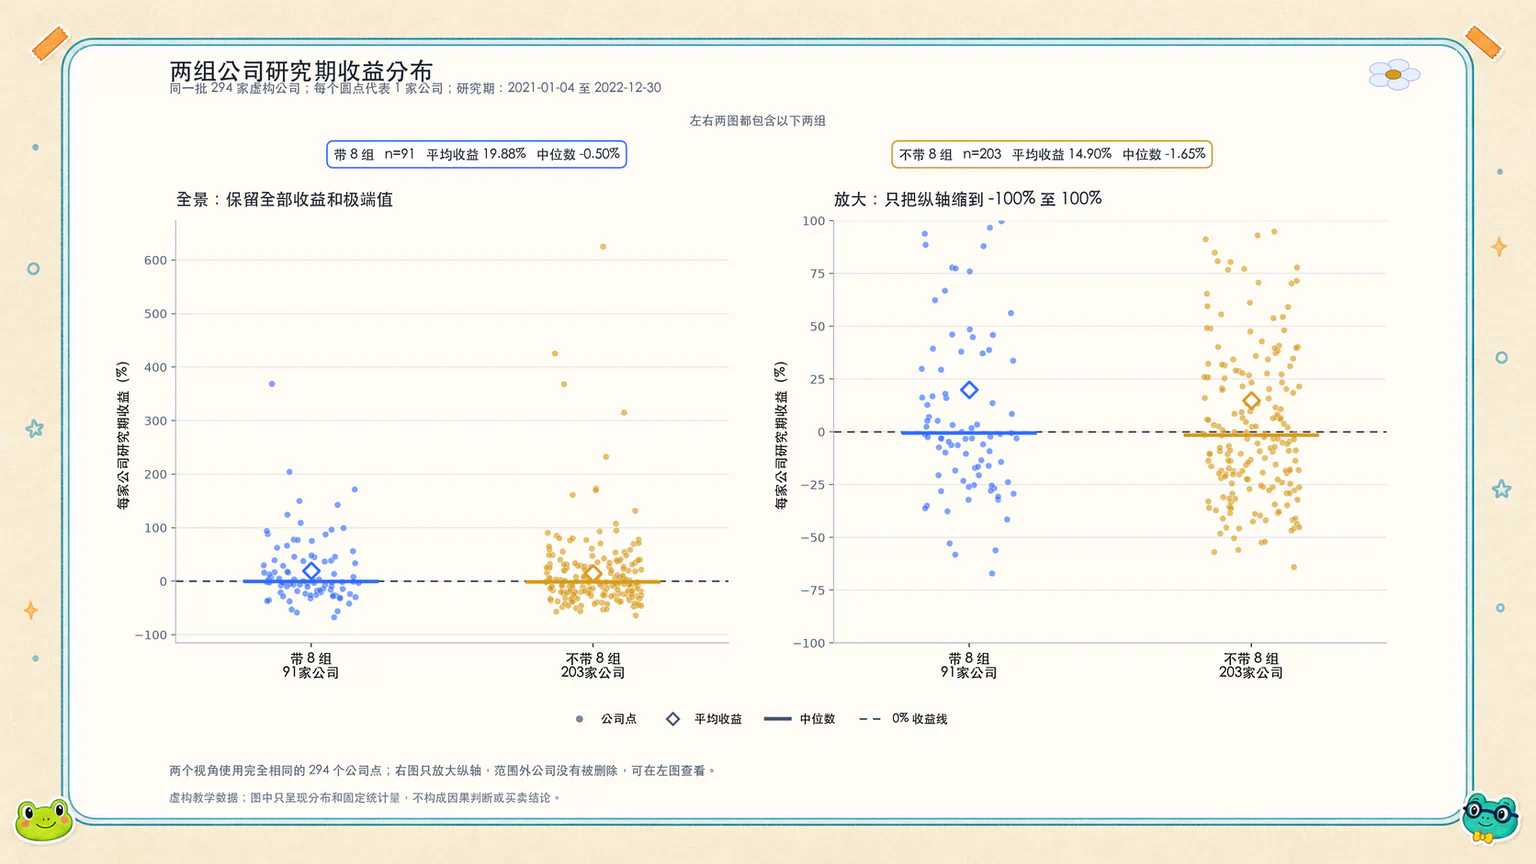
打开分布图,你不会看到两支整齐分开的队伍。
带 8 组里既有上涨公司,也有下跌公司;不带 8 组里同样如此。
有些不带 8 的公司,收益高过大部分带 8 的公司。也有些带 8 的公司,表现比两组中的许多公司都差。
两组的点大量落在相同的收益区域里。
这就是汇总数字容易藏起来的部分:平均收益出现差异,不等于带 8 组里的每家公司都比不带 8 组更好。
完整视角还会让我们看到少数特别高的点。放大视角则让中间那一大群公司不再挤成一团。
两个视角讲的是同一批数据。一个负责保留全貌,一个负责看清大多数公司的位置。
三个数字,分别回答三个问题
现在,我们可以把几个结果重新放回各自的位置。
| 指标 | 它在回答什么 | 它没有回答什么 |
|---|---|---|
| 平均收益 | 每家公司等权以后,这组平均表现怎样 | 组里大多数公司是不是都接近这个数字 |
| 中位数 | 排队后,中间位置的公司表现怎样 | 极端上涨或下跌一共带来了多少影响 |
| 正收益比例 | 有多大比例的公司收益高于零 | 上涨的公司究竟涨了多少 |
| 最大值和最小值 | 这组最极端的结果到了哪里 | 极端结果是不是错误、是否应该删除 |
它们不是四位争夺唯一话语权的裁判。
它们更像四扇窗户。每扇窗户都只能看到房间的一部分。
只看平均收益,我们容易把少数大涨公司想成整支队伍;只看中位数,我们又可能忽略极端结果对整组收益的真实影响;只看正收益比例,则完全看不出上涨和下跌的幅度。
现在的结论,应该写到多强
如果只看平均收益,我们很容易写成:
带 8 的公司收益更高,说明数字 8 可能真的有用。
这句话走得太远了。
它把一段虚构历史数据里的组间差异,直接推成了数字 8 的作用。它也没有交代中位数、正收益比例和极端值正在讲什么。
更符合当前证据的写法是:
在 2021-01-04 至 2022-12-30 的 Hoppy 虚构教学数据中,带 8 组的平均收益高于不带 8 组。但两组中位数都略低于零,正收益比例只相差 2.65 个百分点,而且两组都存在少数极高收益公司。当前结果显示两组在这段历史中出现了一些描述性差异,但不能说明字符 8 带来了这些差异,也不能推出未来表现或买卖规则。
这段话没有假装什么都没发现。
平均收益确实不同,我们如实写下来了。
它也没有因为原假设听起来有趣,就把不整齐的证据修剪成一句漂亮口号。
让 AI 帮我们检查这段判断
我们不需要让 AI 重新计算一遍。现在更重要的是,把准备写进摘要的判断交给它,检查我们有没有把结果说得太满。
和 Codex 一起验收
请不要重新计算,不要修改原研究规则,也不要读取、计算或透露 2023 年收益。
请读取当前研究摘要和公司收益分布图,并检查下面这段准备写入摘要的判断:
“在 2021-01-04 至 2022-12-30 的 Hoppy 虚构教学数据中,带 8 组的平均收益高于不带 8 组。但两组中位数都略低于零,正收益比例只相差 2.65 个百分点,而且两组都存在少数极高收益公司。当前结果显示两组在这段历史中出现了一些描述性差异,但不能说明字符 8 带来了这些差异,也不能推出未来表现或买卖规则。”
请检查它是否同时准确反映了样本数、平均收益、中位数、正收益比例、最大最小值和两组收益分布的重叠情况。
重点检查它有没有把描述性差异写成因果关系、稳定规律、未来预测或买卖建议。如果表述太强,请指出具体是哪一句走得太远,并给出更克制的大白话版本。先向我汇报,不要直接修改文件。
验收的目标不是让 AI 把结论写得什么都不敢说。
我们只是希望它的声音和证据一样大:看见多少,就说多少。
看完 AI 的汇报以后,先由你确认最终采用哪一版表述。确认无误,再让它把结论留下:
把确认后的判断写回摘要
请把我刚刚确认的“第一次暂时判断”追加到现有研究摘要中。保留原有计算结果和内容,不要重新计算,不要改动研究规则,也不要读取、计算或透露 2023 年收益。完成后告诉我你修改了哪个文件,以及新增内容所在的位置。
一个结果,往往会带来更多问题
蛙兄把刚才画的小奖杯擦掉了,但没有把那张结果图关掉。
“所以我们现在什么都不知道?”
“当然不是。”蛙博士说,“我们已经知道,几个汇总数字讲的不是同一件事,也知道两组公司的收益大量重叠。”
“那我还能继续问吗?”
“研究通常就是这样继续的。”
接下来,你可以把问题交还给 AI。我们不预设你应该问什么,也不在课程里替你准备标准答案。
继续和 AI 聊聊
请继续使用当前研究期的数据,不要读取、计算或透露 2023 年收益,也不要修改原来的分组、入选和收益计算规则。
根据现有研究摘要和公司收益分布图,提出几个你认为值得继续追问的问题。请先用大白话说明每个问题想弄清楚什么,不要立即执行分析,等我选择以后再继续。
这些新问题都属于看到结果以后产生的探索。请把它们与原实验事先固定的假设和规则明确区分,不要把探索结果冒充成原实验早已计划好的证据。
AI 可能注意到极端公司,也可能对两组重叠的部分感兴趣,还可能提出你没有想到的问题。
你不必把所有问题都做完。先挑一个你真正好奇的问题,再让 AI 解释它准备怎样继续。
蛙兄没有拆开装着 2023 年数据的信封。
他只是在实验约定旁边,又放了一张空白纸。
第一次结果没有结束研究。
它只是让我们知道,接下来还可以问什么。
平均收益更高,只是结果的一部分。把每个数字和每家公司都看见以后,我们才能写下一个不比证据更夸张的暂时判断。
课后讨论
留下你的问题、理解或不同意见,也看看其他学习者怎么想。