第 2 课
让 AI 从 300 家公司里分出两队
让 AI 先复述实验约定,再对 300 家虚构公司分组、计算并保存可检查的结果。
蛙兄把上一张实验约定放在键盘旁边,又打开了 AI 研究助手。
“假设写了,规则也定了。现在总能开始算了吧?”
蛙博士点点头。
“可以。不过先别让它直接开跑。”
“又要等?”
“不是等。是先确认 AI 眼里的比赛,和我们想的是不是同一场。”
蛙兄看了一眼实验约定。
同样一句“把代码带 8 的公司分出来”,AI 可能有很多种理解:把数字 8 当成字符还是数值?使用原始收盘价还是复权收盘价?缺少起止日数据的公司要不要硬算?2023 年要不要一起打开?
如果这些地方理解错了,程序照样可能顺利运行,甚至还能画出一张挺漂亮的图。
问题是,那张图回答的已经不是我们的问题了。
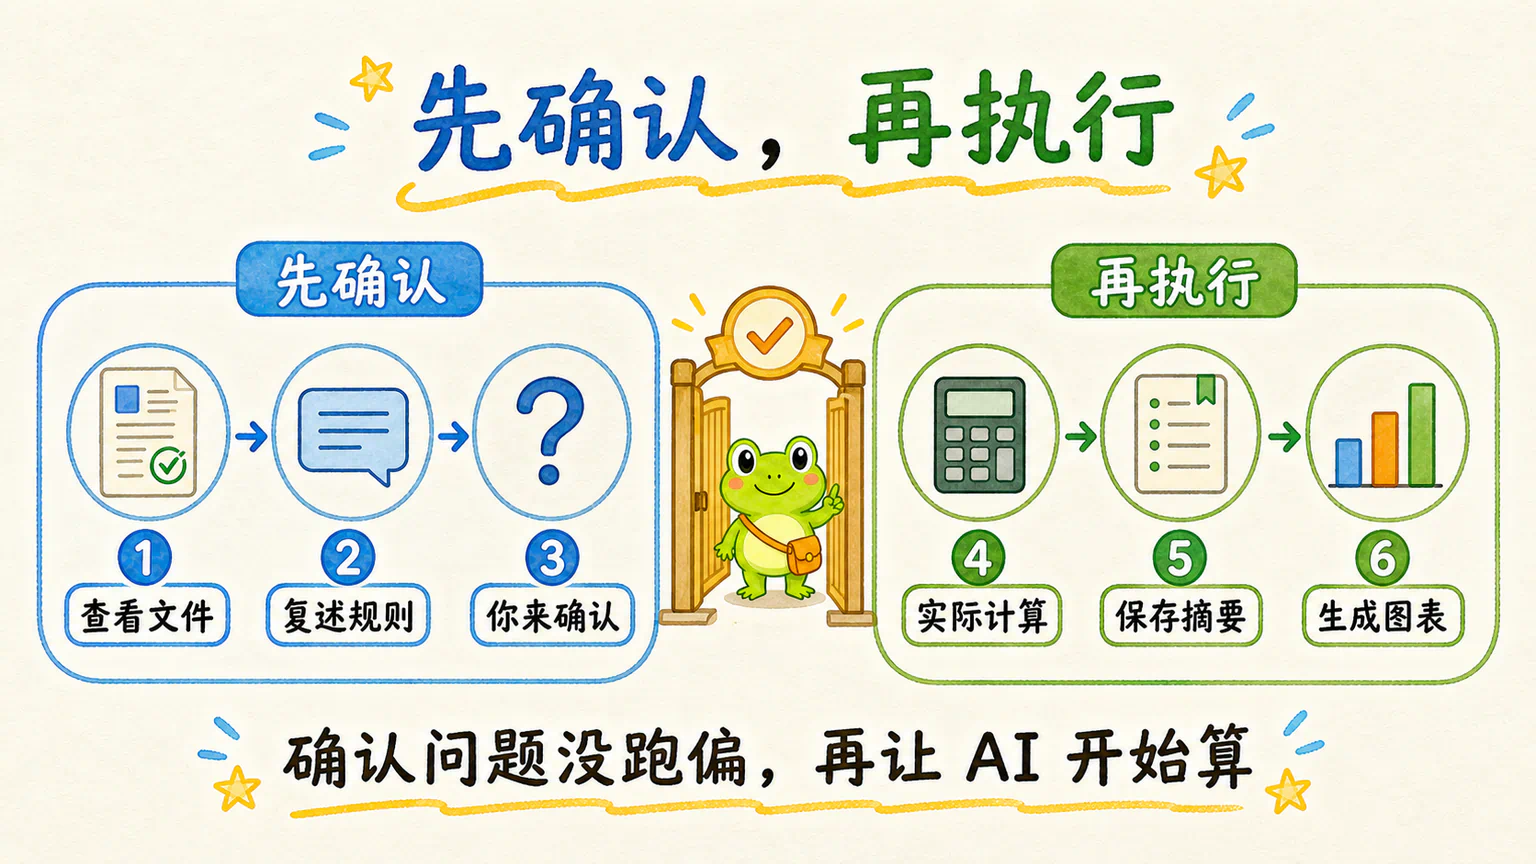
把任务交给 AI 以后,不要只等一句“完成了”。先让它复述准备怎样做,确认没有跑偏,再让它真正计算。
换一个新对话,从一张干净的桌子开始
打开上一课使用的本地实验室文件夹,然后新建一段 Codex 对话。
如果你无法使用 Codex,也可以在 WorkBuddy 中打开同一个文件夹。工具入口可以不同,我们要完成的研究不变。
为什么这次建议新建对话?
因为旧对话里混着环境安装、小游戏、数据读取和 K 线图。那些内容已经完成了自己的任务。现在换一张干净的桌子,更容易看清 AI 是不是只在处理眼前这项研究。
新对话不会自动知道我们前面讲过什么。
它不认识“上一课的约定”,也不知道那封装着 2023 年数据的信。所以,接下来交给 AI 的内容必须自己说得通,不能只写一句:
按我们刚才说的算一下。
第一次先不算,只让 AI 复述
我们把任务分成两段。
第一段只让 AI 查看真实文件,确认字段,并用大白话复述它准备怎样完成实验。
交给 AI 研究助手|先查看和复述
当前项目根目录下应该有一个 hoppy-teaching-dataset 文件夹。请先阅读其中的 README.md、data_dictionary.json 和 manifest.json,再查看 companies.parquet 与 stock_daily.parquet 的实际字段和日期范围。
现在先不要计算两组收益,也不要生成图表。请只确认数据能否支持下面这项研究,并用大白话复述你准备怎样做:
- 研究对象是教学数据中的虚构公司。
- 如果
asset_id中出现字符8,公司进入“带 8 组”;否则进入“不带 8 组”。 - 第一次只研究 2021-01-04 至 2022-12-30。
- 公司只有在 2021-01-04、2022-12-30、2023-01-03 和 2023-12-29 四个端点都有可用的
adjusted_close,才能进入比较。检查 2023 年端点只用于确认数据是否存在,不计算、不比较、也不汇报 2023 年收益。 - 研究期收益使用 2022-12-30 的
adjusted_close除以 2021-01-04 的adjusted_close,再减去 1。 - 最后需要汇报两组的公司数量、平均收益、中位数、正收益比例、最大值和最小值。其中“正收益”指研究期收益严格大于 0。
- 这次不测试其他数字,不加入行业、市值、PE、沪深300或任何买卖规则。
请说明你实际找到的文件、字段和日期能否满足这些要求。如果存在歧义或数据缺失,先告诉我。复述完成后停下来,等我确认,不要提前计算结果。
这段话看起来比“帮我算一下”长,但它不是让你学习怎样写一份技术需求文档。
它只是在说清四件普通的事:研究谁、怎样分队、看哪段时间、最后留下什么。
以后换成别的市场问题,这四件事依然值得先说清楚。
AI 复述以后,重点听什么
AI 可能会换一种说法,也可能采用不同的程序结构。我们不要求它逐字重复任务。
真正需要确认的是下面几件事:
- 它是不是按照代码中有没有字符
8分组; - 第一次是不是只计算 2021-01-04 至 2022-12-30;
- 它是不是使用复权收盘价的起止变化计算收益;
- 它有没有保证前后两次验证使用同一批公司;
- 它有没有把 2023 年只当作“端点数据是否存在”的检查,而不是提前计算收益;
- 它有没有偷偷加入其他数字、行业、市值、PE 或沪深300。
这里有一个地方容易听起来矛盾。
我们说“暂时不看 2023 年”,为什么 AI 又可以检查 2023 年的两个端点?
因为它现在只是在确认一家公司到时有没有资格参加第二次比较,相当于查看入场券是否存在。它不能计算这家公司 2023 年涨了多少,也不能把两组的 2023 年表现告诉我们。
规则已经在数据出现以前固定。现在检查的是数据能不能执行规则,不是在偷看答案。
如果 AI 的复述与实验约定一致,我们只需要明确确认:
你的复述与我的研究约定一致。请继续按这套规则执行,不要增加或修改条件。
如果它说得含糊,不要替它脑补。指出具体是哪一句没说清楚,让它重新复述那一部分。
确认以后,再让 AI 真正计算
接下来才轮到 AI 读取数据、实现计算并实际运行。
交给 AI 研究助手|开始计算
现在请按照刚刚确认的规则实际执行研究。
请先筛选满足四个端点数据要求的公司,再根据 asset_id 中是否包含字符 8 分成两组。只计算和汇报 2021-01-04 至 2022-12-30 的研究期收益,不计算、不比较、也不要在任何输出中透露 2023 年收益。
请汇报:初始公司数、实际入选公司数、被排除公司数和排除原因;两组各自的公司数、平均收益、中位数、正收益比例、最大收益和最小收益。百分比请使用统一单位,并保留两位小数。
请在当前项目的输出目录中保存两份研究证据:
- 一份 Markdown 格式的大白话研究摘要,写清问题、固定规则、数据时间、实际样本数、两组结果和当前边界;
- 一张 PNG 结果图,在同一张图中比较两组的平均收益、中位数和正收益比例,并清楚标出两组样本数。
最大值和最小值写进研究摘要即可,不必塞进结果图。图表只负责展示实际数字,不要添加“数字 8 有效”“应该买入”等结论,也不要添加沪深300、行业、市值、PE、买卖标记或 2023 年数据。
你可以自行决定程序结构和文件名,但必须实际运行程序,确认摘要和图表使用的是同一份计算结果。完成后告诉我保存位置,并用大白话说明你做了什么。不要要求我阅读或解释程序代码。
这段任务没有规定 AI 必须使用哪个 Python 文件,也没有要求你的项目和课程示例长得一模一样。
程序是 AI 用来完成工作的工具。我们真正要留下的是问题、规则和证据。
300 家公司,不一定全部能上场
教学数据里有 300 家虚构公司。
但“数据里有这家公司”和“它能参加这次比较”不是一回事。
如果一家公司在规定的四个端点中缺少任何一个复权收盘价,我们就无法按同一套规则完成前后两次比较。它仍然留在原始数据里,只是这次暂时不能上场。
所以,更准确的过程是:
300 家公司报名
→ 检查四张入场券
→ 符合条件的公司进入共同样本
→ 再分成带 8 组和不带 8 组
不要为了凑满 300 家,让 AI 猜测、填补或制造缺失价格。
样本少了几家不一定说明程序错了。真正需要知道的是:少了谁,为什么少。
我们这次实际跑出了什么
使用当前版本的 Hoppy 教学数据,按照上面完全相同的规则运行后,300 家虚构公司中有 294 家满足四个端点的数据要求。
其中:
- 代码带
8的有 91 家; - 代码不带
8的有 203 家; - 其余 6 家因为缺少
2023-12-29这个资格检查端点的数据,没有进入这次比较。
研究期结果如下:
| 分组 | 公司数 | 平均收益 | 中位数 | 正收益比例 | 最大收益 | 最小收益 |
|---|---|---|---|---|---|---|
| 代码带 8 | 91 | 19.88% | -0.50% | 49.45% | 368.76% | -66.99% |
| 代码不带 8 | 203 | 14.90% | -1.65% | 46.80% | 625.12% | -63.98% |
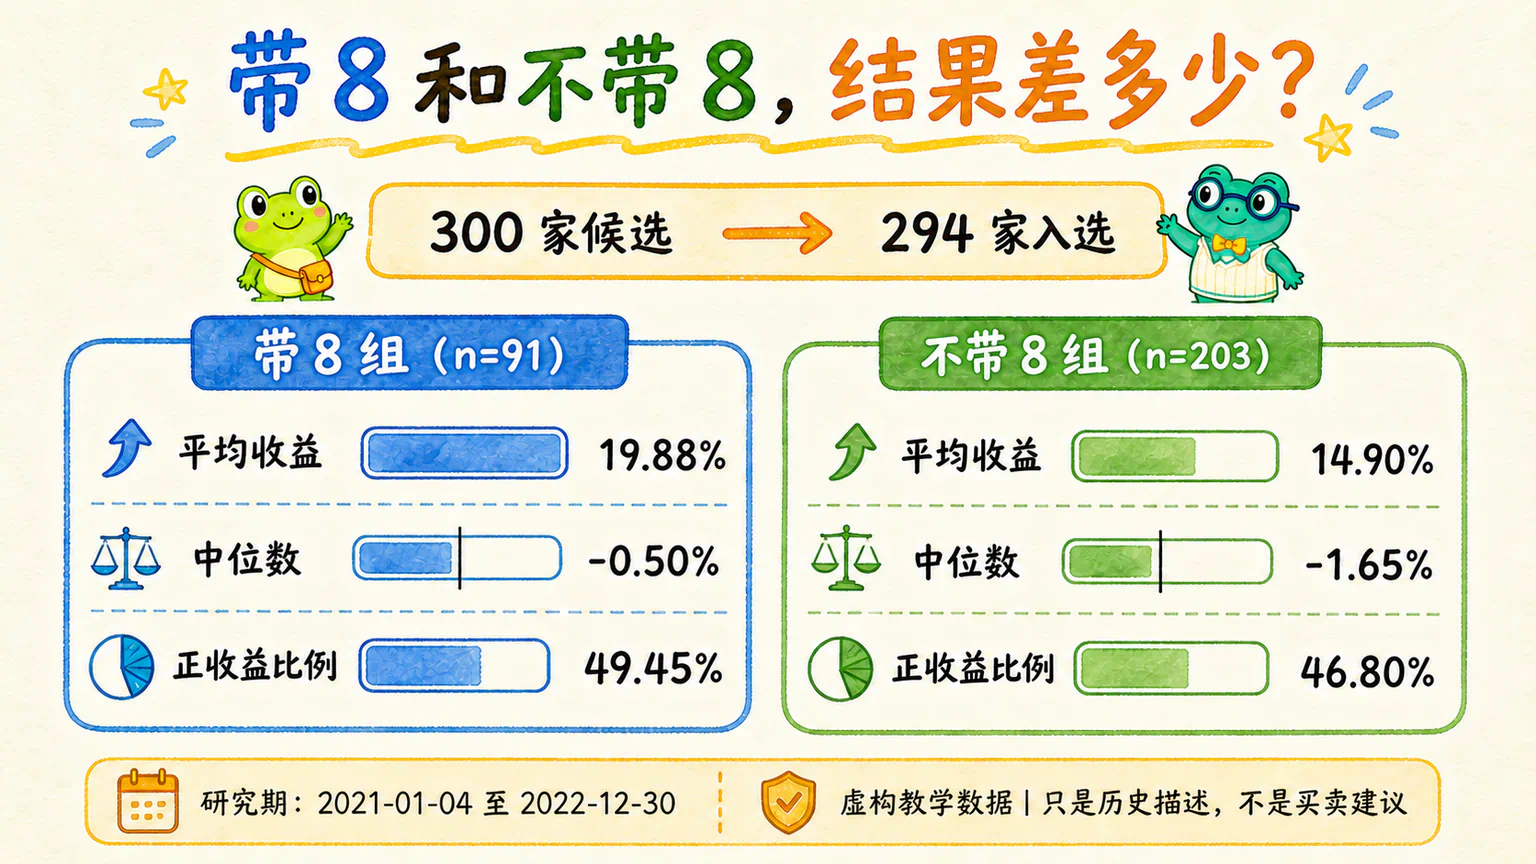
这些数字是课程使用当前教学数据得到的示例结果,不是让 AI 迎合的标准答案。
如果你使用的是同一个数据包和同一套规则,基础数字理应能够对上;如果对不上,先调查数据版本、字段、日期、分组和收益单位,不要让 AI 直接把结果改成课程里的数字。
这轮完整教学会继续使用 Hoppy 虚构教学数据,因为后面几课要一起解读上面的数字。如果你想用自己的数据重复这套方法,当然可以,但请把它当作一条平行练习:后面的示例数字、图表和结论将不能再逐项照搬。
无论使用哪份数据,我们真正检查的都是研究规则有没有被正确执行,不是每个人的图表必须长得一模一样。
如果结果对不上,不要让 AI 猜答案
实战里最有价值的时刻,往往不是一次成功,而是你发现结果有点奇怪的时候。
找不到数据文件
先确认压缩包已经解压到实验室根目录,不要让 AI 又去网上寻找一套同名数据。
可以继续问:
请先查看当前项目的目录结构,告诉我实际找到的数据文件夹和缺少的文件。不要下载或制造替代数据,先说明我需要把文件放在哪里。
样本数和课程示例不同
不要先报出 294 要求它改到一样。
可以问:
不要修改原规则,也不要迎合课程数字。请列出你实际使用的四个端点、入选条件、被排除的公司及具体原因,并检查
asset_id是否按字符串处理。
AI 提前打开了 2023 年
不要假装没看见,也不要继续讨论那部分结果。
可以说:
这一步不应该计算或汇报 2023 年收益。请保留原来的分组和入选规则,删除摘要与图表中的 2023 年结果,只重新整理 2021-01-04 至 2022-12-30 的研究期输出。
图表和摘要里的数字不同
先不要调整配色和布局。
可以说:
请检查摘要和图表是否来自同一份计算结果,逐项核对两组样本数、平均收益、中位数和正收益比例。先修正数字不一致,再处理图表样式。
这几个追问没有替你解决所有报错,但它们守住了同一条原则:先找到哪一步和原约定不一致,再处理那个问题。
AI 说完成了,我们还要打开看看
先打开大白话研究摘要。
看看里面是否真的记录了:
- 研究问题和分组规则;
- 研究期与暂时保留的验证期;
- 实际入选公司数和排除原因;
- 两组的完整结果;
- 没有买卖建议,也没有把历史差异写成未来保证。
再打开结果图。
确认两组名称、样本数和三个主要结果都能读清,图里的数字也与摘要一致。
如果你想让 AI 再帮你核对一次,可以这样说:
和 Codex 一起验收
请不要重新计算,也不要修改文件。请读取刚刚生成的研究摘要和结果图所使用的数据,逐项核对:研究期是否正确、2023 年收益是否没有出现在输出中、两组样本数能否加总为实际入选公司数,以及图表中的平均收益、中位数和正收益比例是否与摘要完全一致。
如果有任何一项不一致,请只说明不一致的位置和建议的修复步骤,先不要擅自修改。
AI 的自检不能代替你亲眼打开文件,但它可以帮助我们把验收问题说得更具体。
有数字了,还没有结论
蛙兄打开结果图,第一眼就看到了两组平均收益。
“带 8 组是 19.88%,不带 8 组是 14.90%。”
他转过头,眼睛亮了起来。
“所以 8 赢了?”
蛙博士没有点头。
“先看看中位数。”
蛙兄又看了一眼。
“两个都是负的。”
“再看看正收益比例。”
“好像又只差一点。”
同一张结果表里,几个数字并没有讲出完全一样的故事。
这不是计算失败。恰恰相反,我们终于得到了一份值得认真读的结果。
AI 已经帮我们把数据算出来了,但“算出来”不等于“看懂了”。有数字以后,下一步不是急着宣布谁赢,而是弄清每个数字究竟在回答什么。
课后讨论
留下你的问题、理解或不同意见,也看看其他学习者怎么想。