第 3 课
漂亮结果,是规律,还是刚好碰上了?
认识不确定性、重复尝试和向前验证,继续追问漂亮结果换一段历史是否仍能站住。
蛙兄在笔记里写下“收益、回撤、夏普”。
“以后看研究报告,总算知道该看些什么了。”
蛙博士点点头:“还可以再问一句:换一段经历,这些结果还站得住吗?”
蛙兄在旁边画了一个问号。
“所以,不光要看数字,还要看看是不是刚好赶上了?”
对。上一课,我们认识了描述账户经历的几个指标。现在再往前一步:看到一份好看的结果,怎样检查它是不是太依赖这一次的经历?
换一批记录,数字会不会变?
还记得之前的随机日期实验吗?换一轮抽样,对照组的平均收益会有些变化。这不是程序一定算错了,而是抽到的日期不完全一样。
我们从一批记录中算出来的结果,也需要这样看待。先从两个小问题入手。
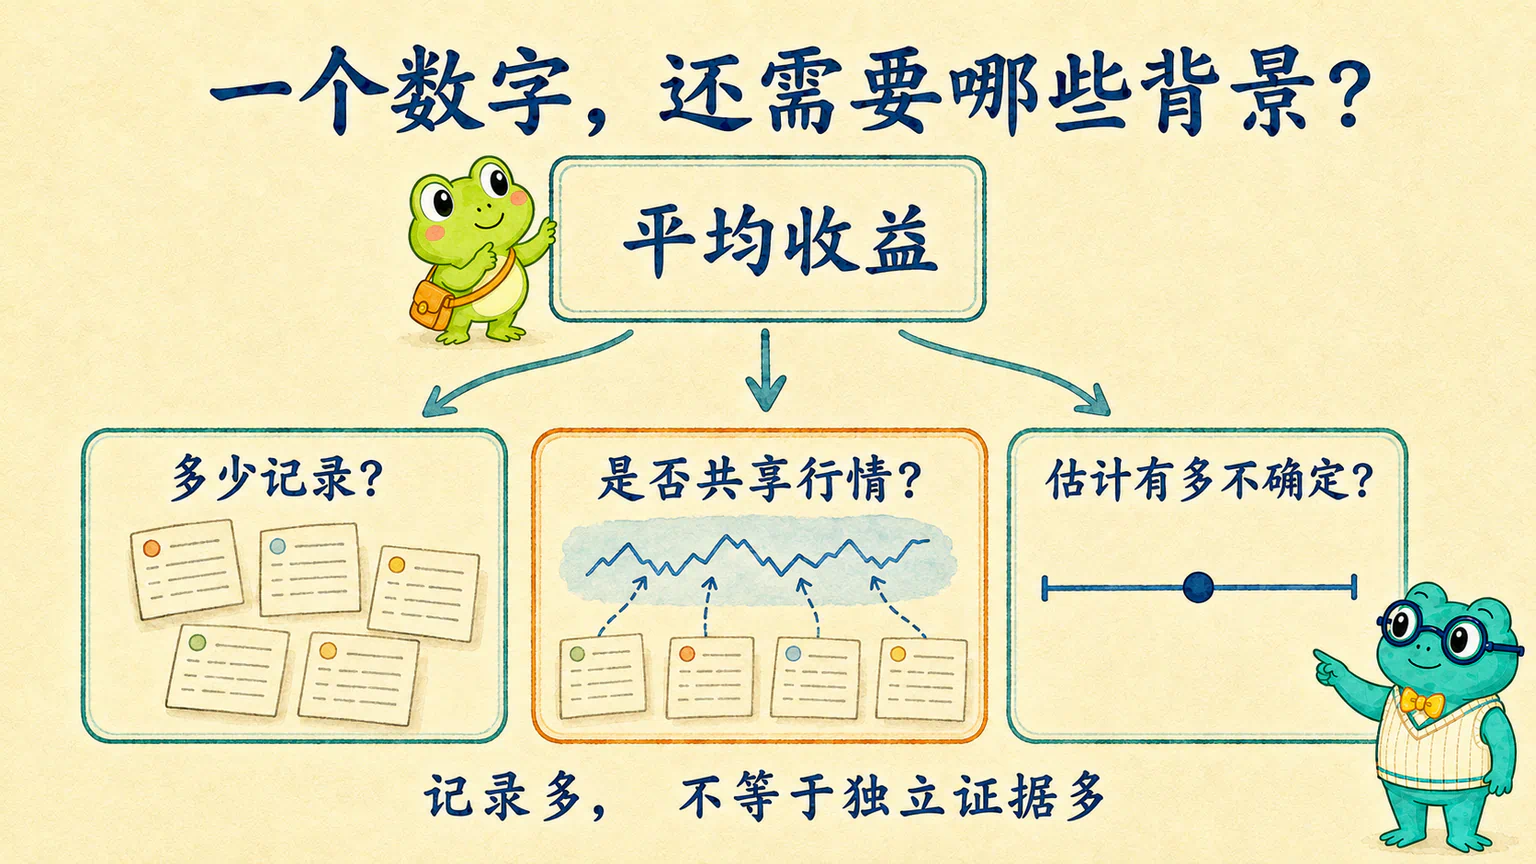
第一个问题:有哪些记录在支持这个结果?
比如,一个平均收益很不错的结果,可能来自许多笔都还可以的交易,也可能主要靠少数几笔大赚撑起来。只看那个平均数,分不清这两种情况。
记录的数量,就是我们常说的样本量。但除了数行数,还要看看这些记录经历了什么。
假如许多股票恰好在同一轮大涨里赚钱,它们多少共享了那段行情。几百笔交易,不一定等于几百次互不相关的检验。有些持有期还会重叠,今天这一笔和明天那一笔,经历了不少相同的交易日。
因此,多一些合适的记录通常有帮助,同时也要留意:它们是不是都挤在少数几段行情里?
第二个问题:这个数字,能估得多准?
换一批记录,平均值可能就会变。只报一个数,容易让人忘记它也有不确定性。
置信区间就是表达这种不确定性的一种方式:除了给出一个估计值,再按统计方法算出一个区间。区间很宽,往往意味着这份数据还不能把数值估得很精确。至于这个区间具体该怎样理解,要看计算方法和假设。NIST:置信区间在表达什么
再接回随机日期实验。我们不只关心“九拍这次比随机日期高了多少”,也会问:如果随机抽日期也经常能碰到这么大的收益,这个结果还算特别吗?
这可以帮助我们理解统计显著性在问什么。先假设规则没有我们想找的优势,再按照约定的随机模型,看看出现眼前这么大、甚至更大的差异有多常见。要这样判断,得先说清假设和方法,不能只凭曲线好看。
哪怕某个差异达到统计显著,也不代表它大到足以抵消费用,更不代表未来赚钱有保证。美国统计学会:统计显著性不等于效果大或结果重要
可选阅读:置信区间和p值,两个容易看错的地方
“95%置信区间”里的95%,描述的是方法:在相关假设成立时,反复按同一方法取样、构造区间,长期来看约95%的区间会覆盖要估计的真实数值。它不是说下一笔交易有95%的概率赚钱,也不是说95%的单笔收益落在这个区间里。
检验结果里常见的p值,则是在设定的假设和模型下,得到当前这么极端或更极端结果的概率。它不是“假设为真的概率”,也不是“这次赚钱纯属运气的概率”。一个门槛不能代替对样本、差异大小和研究过程的检查。
如果AI给你这些数字,可以先追问:它估计或检验的究竟是什么?怎样处理同一行情、重叠持有期带来的联系?不是看见一个统计名词,就代表这些问题已经解决。
这张成绩单,是从多少张里面挑出来的?
再想象一个场景。
蛙兄继续探索自己的规则,终于找到一个收益和夏普都挺好看的版本。
“这次这个不错。”
“你一共试了几个?”蛙博士问。
蛙兄往下滚了滚文件夹。
又滚了一会儿。
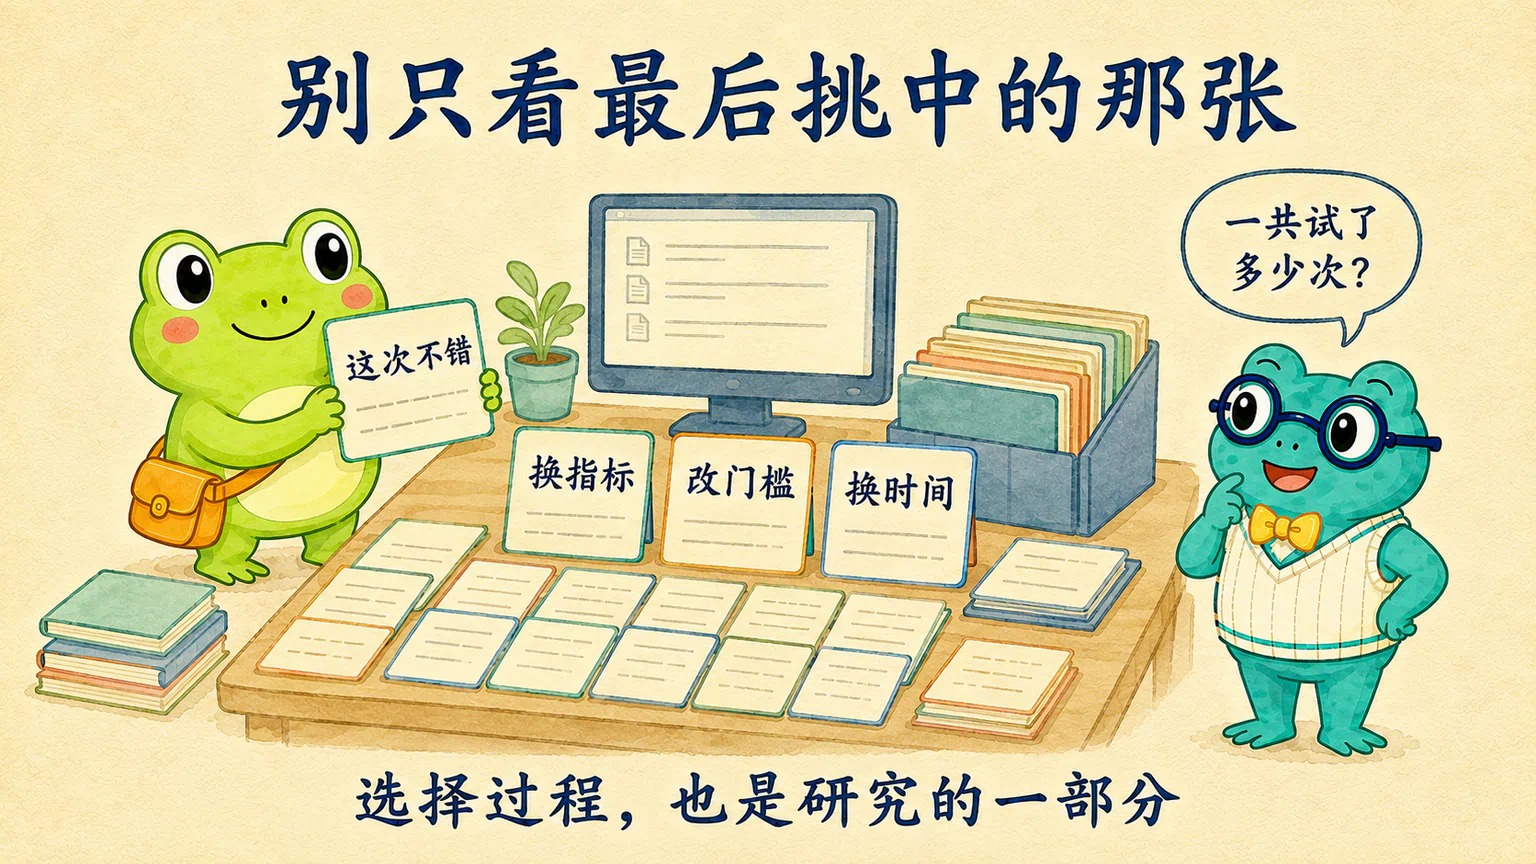
换个指标、挪一下门槛、换个持有时间,都是正常的探索。但如果试了很多种,最后只拿最漂亮的一张成绩单出来讲,就漏掉了一个重要背景:它是从许多次尝试中选出来的。
哪怕一些规则没有真正的优势,也可能恰好适合这段历史。尝试越多,碰到这类漂亮结果的机会也会增加。这就是反复检验时需要注意的多重检验问题,不能仍然把胜出的那一次当成唯一做过的检验。Bailey等:回测过拟合与反复尝试
如果我们一直照着旧数据修修补补,规则可能越来越会应付它见过的那段行情,却没有学到能延续到别处的东西。这种把旧数据里的偶然细节也当成规律的情况,叫作过拟合。不是只有机器学习才会遇到,手动加条件一样可能发生。
“那我还改不改了?”
可以改。问题不在于探索,而在于把探索过程藏掉,仿佛那个好结果一开始就在那里等我们。
你不必为每次尝试写长报告,但至少让自己和AI知道试过什么、为什么选中这一版。被淘汰的版本同样属于研究背景,不要只留下冠军。
还要留意,验证数据一旦被用来指导修改,就不能继续装作它没被看过。我们已经打开过2023年的结果;如果现在根据它改规则,再测同一年,那是在继续探索,不是又获得了一次全新的独立验证。
除了再换一年,还能怎么检查?
先从一个小动作开始:把条件稍微挪一挪。
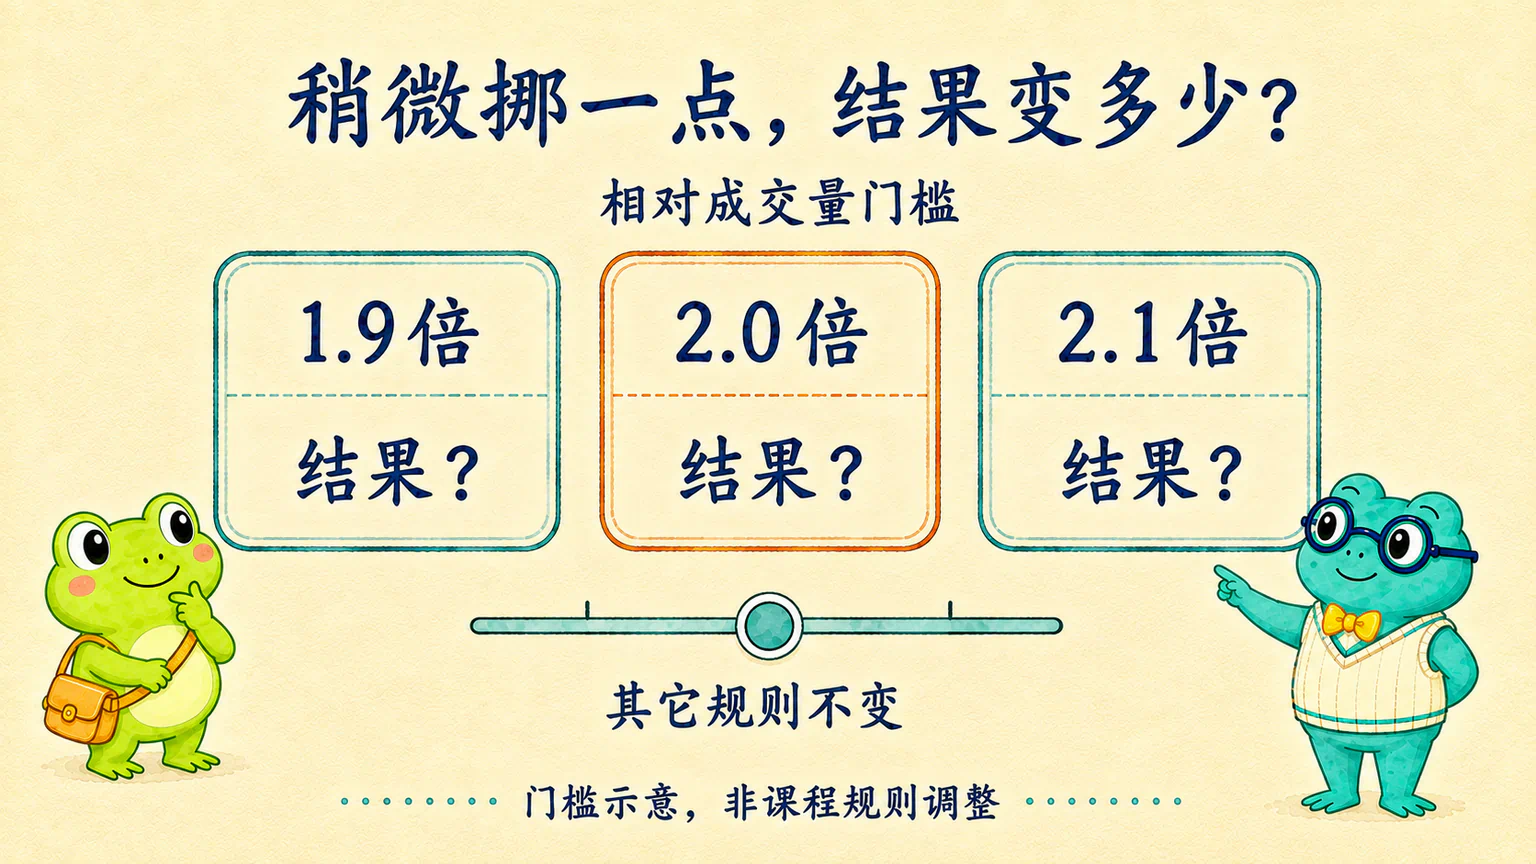
假设某次研究设了一个相对成交量门槛:今天的成交量至少达到所选历史平均成交量的2倍,才考虑买入。
那1.9倍和2.1倍呢?其它规则不变,附近的门槛会得到什么结果?
这里的数值只是举例,不是在修改我们之前的买入标准。
如果2倍那个点特别漂亮,左右稍微一动就完全变样,我们就需要继续问:为什么差这么多?是不是恰好增减了几笔影响很大的交易?
研究这种“数字稍微一改,结果跟着变多少”的问题,叫作参数敏感性检查。
它不是要求附近所有版本都赚钱,也不是宣布变化大就一定无效,而是避免只盯着最顺眼的那一个点。稍微换个合理条件,主要判断是否还站得住,是稳健性研究关心的一类问题。
另一个办法,是沿着时间一段一段往前走。
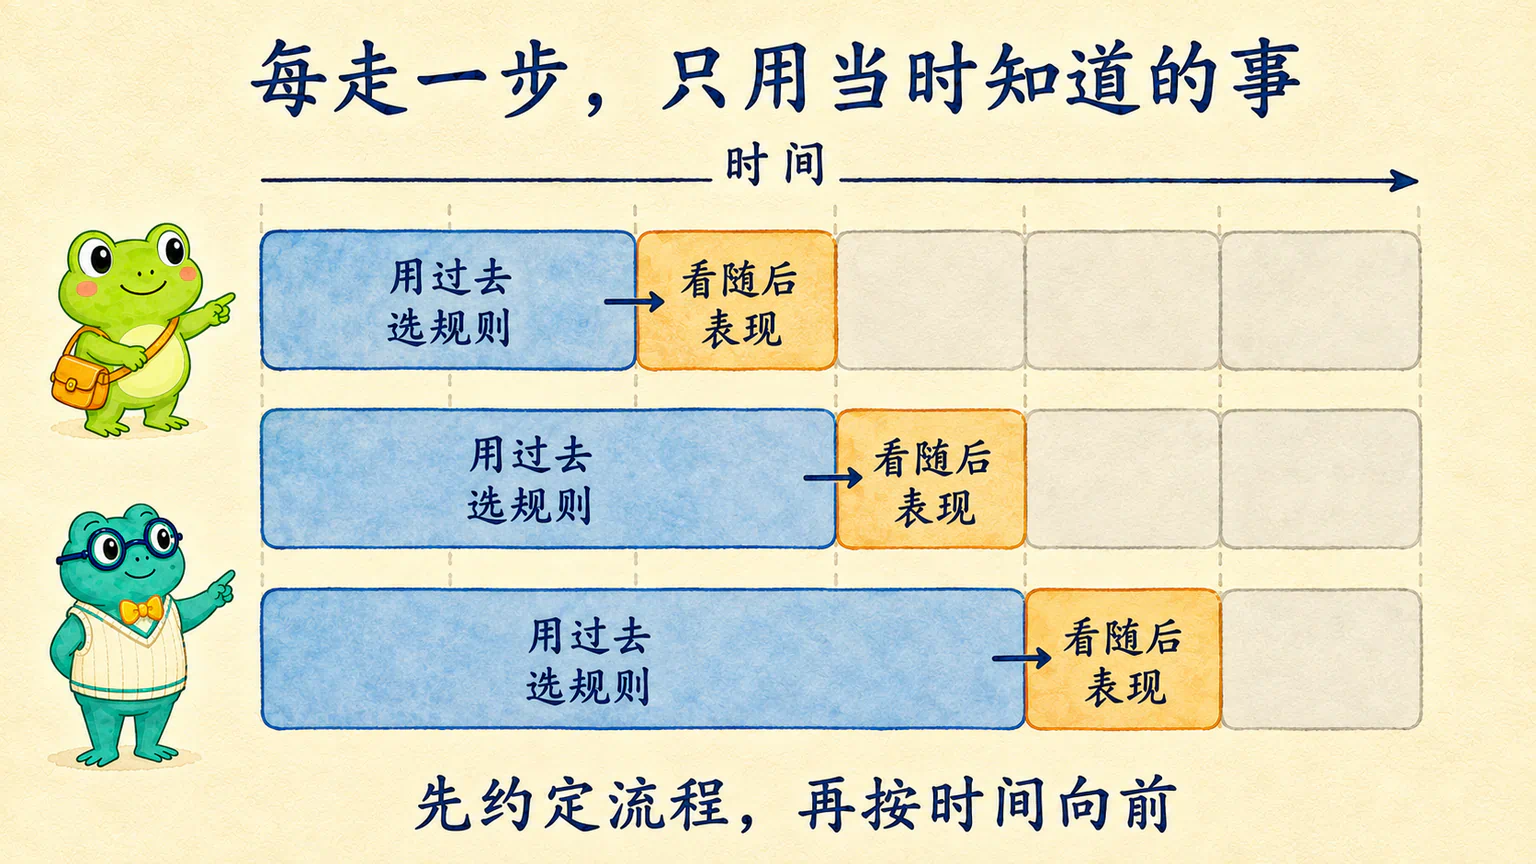
我们之前的做法,是先在一段历史里研究,再打开后面的数据。把这个想法延展一下,就可以这样安排:
先约定每轮怎样选规则、看多长时间。第一轮只用当时已经完整发生的记录作选择,再观察接下来的一段;到了下一轮,时间向前推进,用那时已经知道的记录作选择,再看更后面的一段。
这就是滚动验证的一种思路。它让我们不只看一次前后划分,也观察沿时间推进时,研究办法会经历什么。关键不是图上有多少格,而是每一轮都守住先后顺序。《Forecasting: Principles and Practice》:沿时间推进的验证
当然,如果看完这些分段结果,又不断调整“怎样选规则”,这套流程本身也会被我们挑选。不能因为名字里有“验证”,就自动免疫前面说的过拟合。
所以,滚动验证也不是把旧数据切得越碎越好,更不是切几次就多拿几张合格证。它提供的是另一种检查角度。
先说清自己担心哪一件事
讲到这里,蛙兄把新名词写了一排。
“是不是全部做完,才算过关?”
不用把它们变成新的打卡清单。更有用的是,先说清楚自己在担心什么。
| 我担心的是…… | 可以继续了解的方向 |
|---|---|
| 这个数字太依赖这批记录 | 样本、估计的不确定性、合适的统计检验 |
| 试了太多次,才挑出一个好看的 | 选择过程、多重检验、过拟合 |
| 门槛稍变,主要判断就站不住 | 参数敏感性、稳健性 |
| 只看一次时间划分还不够 | 沿时间推进的验证方法 |
这些方法不是为了保证以后赚钱,而是帮我们更有理由地决定:继续查哪一件事,暂时保留什么判断,又有哪些话还不能说。
不只看结果多漂亮,还要看它来自哪些记录、经历了多少次挑选,以及换个合理条件后会怎样。
和 AI 讨论稳健性
如果想继续,你可以在Codex或WorkBuddy里,结合已有研究问一个具体问题,比如:“我担心这个结果主要靠少数几笔交易撑起来。先看看现有记录,我们可以怎样检查?”
让AI区分已经看到的事实和还没验证的解释。先讨论一种合适的办法,再决定要不要运行;不需要一口气增加所有检验,也不要为了做检查随意修改原始结果。
蛙兄在笔记里多写了一个问题:“还想检查,这个结果是不是太依赖某几段行情。”
这就比只盯着一个漂亮数字,多走了一步。
但即使历史证据更可靠,还有一件现实的事没问完:程序里假设能买到、能卖出的交易,换成真正的资金,就一定能完成吗?
下一课,我们就从这里继续。
课后讨论
留下你的问题、理解或不同意见,也看看其他学习者怎么想。